Ihr KI-Pilotprojekt funktioniert. Ist es bereit für den Produktiveinsatz?
Wenn Ihr KI-Pilotprojekt funktioniert, haben Sie den schwierigen Teil, von dem alle sprechen, bereits hinter sich gebracht. Sie haben ein echtes Problem ausgewählt, etwas entwickelt und beobachtet, wie es seine Aufgabe erfüllt. Das ist mehr, als viele Unternehmen schaffen.
Es gibt noch einen zweiten schwierigen Teil, der weitaus weniger Beachtung findet. Er liegt zwischen „Es funktioniert, wenn wir es vorführen“ und „Es hält stand, wenn echte Kunden, echte Daten und echte Fehler ins Spiel kommen“. In dieser Kluft bleiben die meisten KI-Pilotprojekte stehen.
In diesem Beitrag geht es darum, was sich tatsächlich in dieser Lücke befindet und wie Sie Ihr eigenes Pilotprojekt daran messen können.
Die Kurzfassung
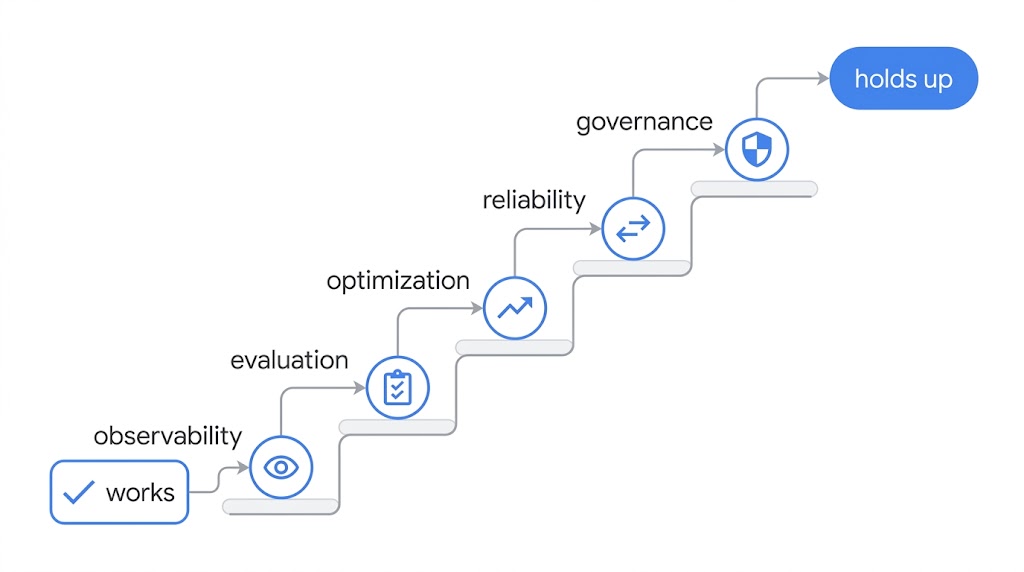
Ein Pilotprojekt beweist, dass eine Idee einmal funktioniert. Der Produktivbetrieb braucht fünf Dinge, die die meisten Pilotprojekte überspringen:
- Sie können sehen, was das System getan hat (Beobachtbarkeit)
- Sie testen es an bekannten Fällen und im laufenden Betrieb (Bewertung)
- Sie nutzen die Testergebnisse, um es zu verbessern (Optimierung)
- es übergibt sicher an Menschen, wenn es überfordert ist, statt zu raten (Zuverlässigkeit)
- und es ist sicherheitsgeprüft und nach einem echten Standard dokumentiert (Governance).
Prüfen Sie alle fünf Punkte, bevor Sie den Rollout finanzieren. Fünf Fragen, mit denen Sie Ihr eigenes Pilotprojekt testen, finden Sie am Ende.
Der Start ist nicht das Schwierige. Durchzuhalten ist es.
Fast jeder hat bereits angefangen. Weitaus weniger haben etwas im Produktivbetrieb, das sich bewährt.
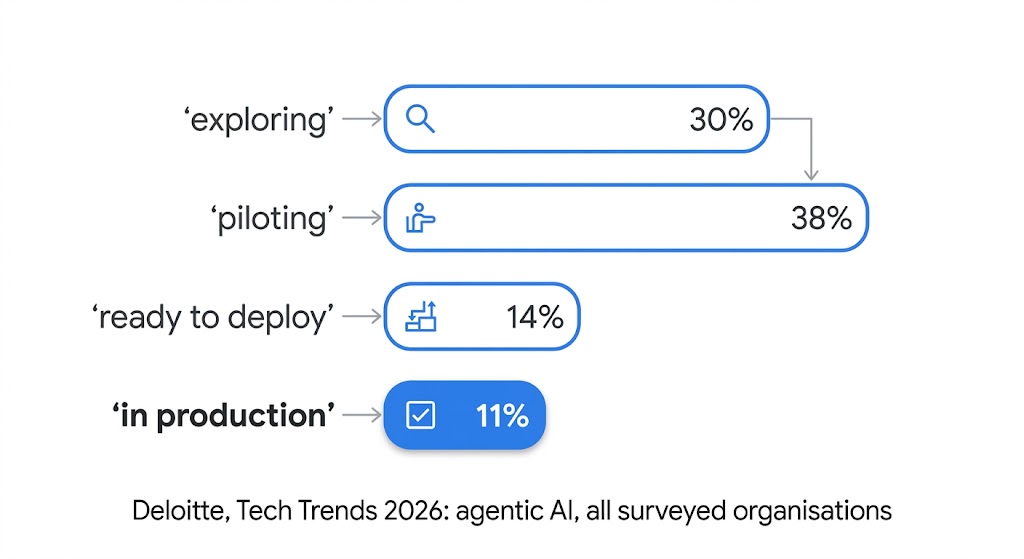
11 % der Unternehmen setzen agentische KI aktiv im Produktivbetrieb ein. Weitere 38 % befinden sich noch in der Pilotphase. Das stammt von Deloitte 1 und bezieht sich auf alle befragten Unternehmen; weitere 30 % sondieren das Thema, und 14 % haben eine Lösung einsatzbereit.
Andere Studien kommen zu ähnlichen Ergebnissen:
- S&P Global Market Intelligence 2 (Mai 2025, Umfrage unter 1.006 IT- und Fachexperten in Nordamerika und Europa, Schwerpunkt generative KI): 42 % der Unternehmen haben die meisten ihrer KI-Initiativen vor dem Produktivbetrieb aufgegeben, nach 17 % ein Jahr zuvor. Im Durchschnitt melden die Unternehmen, dass 46 % der Projekte zwischen Proof of Concept und breiter Einführung verworfen wurden.
- MIT NANDA 3 (Juli 2025): 95 % der generativen KI-Pilotprojekte in Unternehmen zeigen keine messbare Wirkung auf die Gewinn- und Verlustrechnung. Lesen Sie das als Richtwert: Die Autoren nennen es vorläufig, es stützt sich überwiegend auf Interviews mit 52 Organisationen, ist nicht von Fachkollegen begutachtet und definiert Erfolg eng.
- LangChain 4 (1.340 Befragte, Ende 2025): 57 % haben Agenten im Produktivbetrieb, und Qualität ist mit 32 % das größte Hindernis. Befragt wurden Teams, die bereits Agenten bauen, überwiegend kleinere Tech-Unternehmen, nicht alle Organisationen wie bei Deloitte; deshalb liegt die Quote im Produktivbetrieb höher als Deloittes 11 %.
Alles zusammen ergibt ein klares Muster. Die Lücke liegt nicht im Start, sondern im Durchhalten. Futurice hat es in einer Stellenbeschreibung gut gesagt: „Weitaus weniger haben etwas in den Produktivbetrieb gebracht, das unter realer Last, mit echten Daten und echter Prüfung standhält.“
Lücke 1: Beobachtbarkeit. Können Sie sehen, was es getan hat?
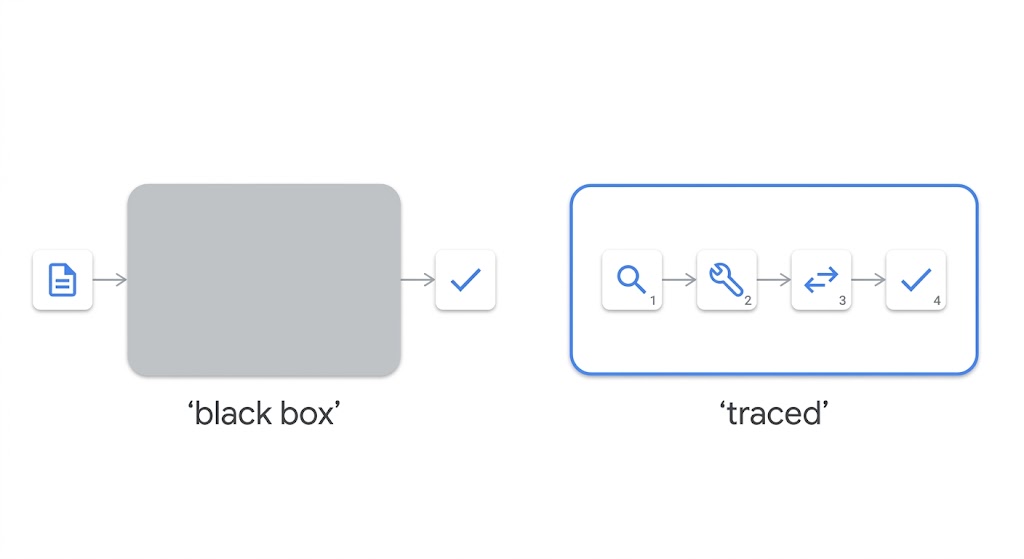
Beobachtbarkeit bedeutet, dass Sie genau rekonstruieren können, was die KI getan hat und warum: jeden Modellaufruf, jedes genutzte Tool, jede Übergabe zwischen Schritten. Nicht nur die Antwort, sondern auch, wie sie zustande kam.
Sie steht aus einem einfachen Grund an erster Stelle, und das AgentOps-Framework von IBM 5 bringt es auf den Punkt: Was man nicht sehen kann, kann man nicht messen, und was man nicht messen kann, kann man nicht verbessern.
Fehlt sie, sieht das so aus: Jemand fragt „Warum hat das System das so entschieden?“, und die ehrliche Antwort ist eine Vermutung. Oder die Monatsrechnung fällt höher aus als erwartet, und niemand kann sagen, welcher Schritt sie verursacht hat. Deloitte 1 warnt, dass schlecht konfigurierte Agenten Aktionsketten auslösen können, deren Kosten explodieren; deshalb brauchten Agenten eine eigene Kostenerfassung.
Bei jedem KI-System lohnt es sich, nach drei Zahlen zu fragen:
- Wie lange jeder Fall von Anfang bis Ende dauert
- Was jeder Fall kostet
- Wo Übergaben zwischen den Schritten fehlschlagen
Das ist die Lücke, die die meisten Teams inzwischen zu schließen begonnen haben. In der Umfrage von LangChain 4 unter Teams, die Agenten bauen, haben 89 % eine Form von Beobachtbarkeit. Bei Teams mit Agenten im Produktivbetrieb sind es 94 %, und 71,5 % davon haben vollständiges Tracing. Betrachten Sie sie also als Grundvoraussetzung. Die eigentliche Frage ist, ob Sie sie tatsächlich haben oder es nur glauben.
Prüfen Sie es selbst
Wählen Sie einen realen Fall aus der letzten Woche. Bitten Sie Ihr Team, Ihnen allein anhand der Protokolle – nicht aus der Erinnerung einzelner Personen – zu erklären, was die KI gelesen, entschieden und getan hat. Wenn das nicht gelingt, haben Sie noch keine Beobachtbarkeit.
In meinem Testsystem
Mein Testsystem für Kostenübernahmeanträge läuft als synthetischer Benchmark mit 20 Fällen pro Runde, und jeder Fall wird in LangSmith nachverfolgt, einem Werkzeug, das jeden Schritt aufzeichnet. Wenn ein Fall scheiterte, zeigte die Nachverfolgung genau den Schritt, an dem es brach: Weiterleitung, Verarbeitung der Belege oder Übergabe an einen Menschen.
Lücke 2: Bewertung. Wissen Sie, ob es überhaupt etwas taugt?
Beobachtbarkeit sagt Ihnen, was passiert ist. Die Bewertung sagt Ihnen, ob es richtig war. Hier liegt der größte Einbruch.
In derselben LangChain-Umfrage 4 können 89 % der Teams ihre Agenten nachverfolgen, aber nur 52,4 % testen sie offline an einem Satz bekannter Fälle, und 37,3 % bewerten den Live-Betrieb. Von den Teams, die überhaupt bewerten, tut nur etwa ein Viertel beides. Und Qualität ist mit 32 % das größte Hindernis auf dem Weg in den Produktivbetrieb. Diese Zahlen hängen zusammen: Qualität, die Sie nicht messen, können Sie nicht beheben.
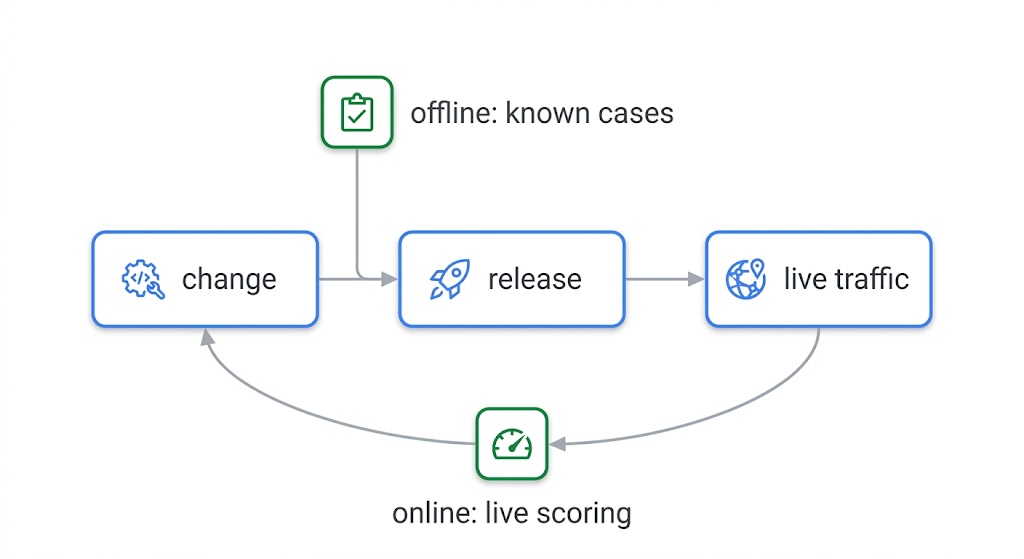
Es gibt zwei Arten der Bewertung, und man braucht beide.
Offline: bekannte Testfälle, vor jeder Änderung
Eine Reihe echter Beispiele mit bekannten richtigen Antworten, einschließlich der kniffligen Randfälle. Jede Änderung an einem Prompt, einem Modell oder einem Tool läuft vor der Freischaltung dagegen. Ohne das kann eine kleine Anpassung unbemerkt etwas kaputtmachen, das vorher funktioniert hat, und niemand merkt es, bis es ein Kunde tut.
Online: Live-Betrieb, nach der Veröffentlichung
Echte Nutzer bringen Fälle mit, die sich Ihr Testsatz nie vorgestellt hat. Die Online-Bewertung bewertet laufende Arbeit, für die es keinen Lösungsschlüssel gibt, zum Beispiel indem sie Gespräche markiert, in denen ein Nutzer „Das ist falsch“ sagt oder eine Fehlermeldung zurückkopiert.
Offline findet, was Sie kaputtgemacht haben. Online findet, woran Sie nie zu testen gedacht haben.
Zwei weitere Gewohnheiten unterscheiden echte Bewertung von bloßem Bauchgefühl:
- Testen Sie an Fällen, die das System noch nie gesehen hat. Ein System, das an denselben Fällen gemessen wird, auf die es abgestimmt wurde, sieht immer besser aus, als es ist.
- Lassen Sie Ihre Fachleute den Maßstab setzen. Die Menschen, die die Arbeit heute machen, entscheiden, was „richtig“ heißt. Automatisierte Prüfungen wenden ihr Urteil dann in großem Maßstab an.
Kaufen Sie KI bei einem Anbieter ein, ist das auch Ihr bester Hebel im Vertrag. Covista hat es in einer Stellenbeschreibung klar gesagt: Testfälle gehören in jeden Vertrag über KI-Entwicklung, „keine Bewertung, keine Produktion.“ Eine Klausel, die sich zu übernehmen lohnt.
Prüfen Sie es selbst
Stellen Sie vier Fragen. Wie viele Testfälle haben wir? Woher stammen sie? Wann liefen sie zuletzt? Wohin entwickelt sich die Erfolgsquote? Eine vage Antwort auf irgendeine davon bedeutet, dass diese Lücke offen ist.
In meinem Testsystem
In der ersten Runde erreichte das System bei 20 Fällen 70 % korrekte Bearbeitung: das richtige Ergebnis für jeden Fall, keine Automatisierungsquote. Die zweite Runde nutzte 20 neue Fälle, die das System nie gesehen hatte, und erreichte 85 %. Neue Fälle machen den Test schwieriger und nicht direkt vergleichbar, und 20 Fälle sind eine kleine Stichprobe.
Lücke 3: Optimierung. Wenden Sie das Gelernte an?
Bewertung ohne Optimierung ist ein Zeugnis, auf das niemand reagiert. Optimierung heißt, die Ergebnisse der Bewertung zu nutzen, um das System besser zu machen, und dann nachzuweisen, dass es besser geworden ist. Hier entstehen die echten Erfolge.
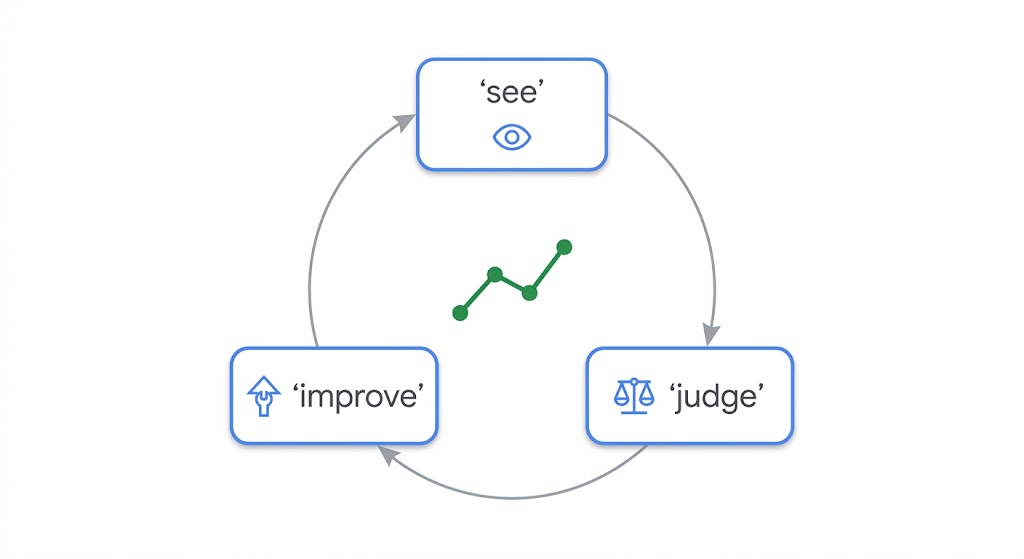
Der Pilot ist Version eins. Niemand bekommt ein KI-System gleich beim ersten Mal richtig hin, weil niemand jeden Fall vorhersehen kann, den die Praxis liefert. Der Wert wächst mit jeder getesteten Korrektur: eine Routing-Regel, die geschärft wurde, ein Abrufschritt, der abgestimmt wurde, ein Prompt, der klarer wurde. Jede für sich ist klein. Zusammen machen sie den Unterschied zwischen einer Demo und etwas, dem Sie Kunden anvertrauen würden.
Drei Regeln sorgen dafür, dass es funktioniert:
- Zielen Sie auf Geschäftsergebnisse, nicht nur auf technische Genauigkeit. „Hat es die richtige Maßnahme gewählt?“ und „Hat es eskaliert, als es nötig war?“ zählen mehr als ein Modell-Score. Das gilt auch für die Kosten pro Fall.
- Korrigieren Sie das System, nicht den Test. Fällt eine Prüfung durch, ist die verlockende Lösung, die Prüfung aufzuweichen. Richtig ist, das System zu ändern und es dann an neuen Fällen erneut nachzuweisen.
- Treffen Sie Zielkonflikte offen. Bessere Qualität kann mehr Zeit oder Geld kosten. Das ist in Ordnung, solange jemand es bewusst entschieden hat.
Zwei Zahlen zeigen, ob es passiert. Verbesserungstempo: Wie viele getestete Verbesserungen gehen jede Woche live? Und Kosten pro Fall, über die Zeit verfolgt, damit „besser“ nie unbemerkt zu „teurer, als es wert ist“ wird.
Auch die Finanzen gehören in diesen Kreislauf. Dells CTO John Roese sagte gegenüber Deloitte 1, dass bei Dell nichts in den Produktivbetrieb geht, bevor ein Finanzpartner und die Leitung des Geschäftsbereichs einen soliden ROI freigegeben haben. Alles andere bleibt ein Experiment.
Prüfen Sie es selbst
Fragen Sie: Was war die letzte Änderung, die wir wegen eines Testergebnisses gemacht haben, und welche Zahl hat sich bewegt? Kann niemand eine nennen, liefert die Bewertung Berichte, keine Verbesserungen.
In meinem Testsystem
Zwischen den Runden habe ich drei Fehler bei Weiterleitung und Belegverarbeitung behoben, die die erste Bewertung gefunden hatte. Die Kosten pro Fall, einschließlich der automatischen Bewertung jedes Tests, stiegen von 0,027 $ auf 0,029 $; die Modellkosten des Systems selbst liegen unter einem Cent. Nicht enthalten ist die Zeit, die Menschen für die Prüfung aufwenden.
Lücke 4: Zuverlässigkeit. Was passiert, wenn es etwas nicht weiß?
Jedes KI-System trifft auf Fälle, die es nicht bewältigen kann. Zuverlässigkeit heißt, dass jede Stelle, an der es scheitern kann, eine definierte, sichere Ausweichlösung hat: an eine benannte Person eskalieren, den Fall anhalten oder weitere Informationen anfordern. Was es nie tut, ist raten.
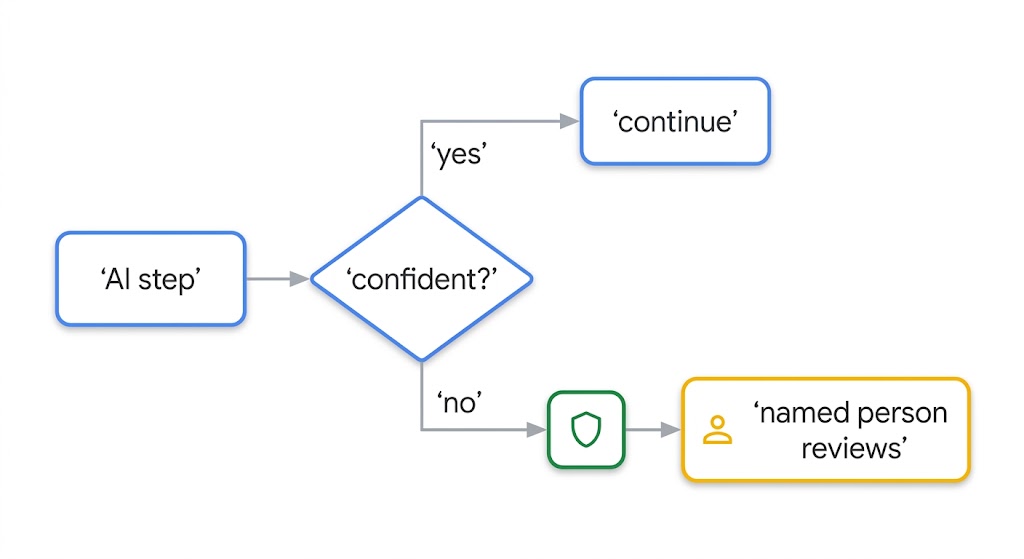
Qualität ist in der Umfrage von LangChain 4 das größte Hindernis auf dem Weg in den Produktivbetrieb, und kein System erreicht perfekte Qualität. Eine sichere Ausweichlösung macht es sicher, unvollkommene Qualität zu betreiben.
Deloitte 1 beschreibt denselben Gedanken von der Seite der Menschen: „Agent Supervisors“, Personen, die an Übergabepunkten eingreifen, die bewusst entworfen wurden – und nicht erst dann, wenn jemand zufällig ein Problem bemerkt. Die Übergabe ist Teil des Designs, nicht sein Versagen.
VESTIGAS beschrieb das Ziel in einer Stellenbeschreibung: ein System, das weiß, „wann es ein Dokument zur menschlichen Prüfung markieren muss, statt stillschweigend zu raten“.
Drei Dinge machen eine Ausweichlösung real:
- Schriftlich festgehalten. Für jeden Schritt: Was passiert, wenn er scheitert, und wer übernimmt?
- Aus Daten abgeleitet. Der Punkt, ab dem ein Schritt ohne menschliche Prüfung laufen darf, ergibt sich aus Testergebnissen, nicht aus Hoffnung.
- Begrenzt. Ein Agent in einer Wiederholungsschleife gibt weiter Geld aus. Es sollte eine harte Obergrenze oder einen Alarm für Ausgaben geben, und jemand sollte getestet haben, dass beides funktioniert.
Prüfen Sie es selbst
Bitten Sie darum, drei Fälle zu sehen, in denen die KI eskaliert hat, und einen, in dem sie es hätte tun sollen, aber nicht getan hat. Findet niemand sie, wissen Sie noch nicht, wie das System scheitert.
In meinem Testsystem
In zwei Runden mit insgesamt 40 synthetischen Fällen führte das System keine unsicheren Aktionen aus, und jeder Fall endete bewusst mit der Entscheidung eines Menschen: Nichts verlässt die Sandbox ohne menschliche Freigabe, also lief kein Fall komplett automatisch durch. Zur korrekten Bearbeitung gehört, einen Fall an einen Menschen zu übergeben, wenn es nötig ist.
Lücke 5: Governance. Können Sie nachweisen, dass es sicher ist?
Governance entscheidet darüber, ob Sie das System verteidigen können, wenn etwas schiefgeht. Sie besteht aus drei Teilen.
Sicherheit: Kann es angegriffen oder missbraucht werden?
Bezugspunkt ist OWASP, die offene Sicherheits-Community. Ihre Top 10 für LLM-Anwendungen 6 gilt für jedes KI-System: Prompt Injection ist der bekannteste Eintrag, bei dem jemand Anweisungen in einem Dokument oder einer E-Mail versteckt, die die KI liest, und die KI sie befolgt. Sobald ein System Werkzeuge nutzen, sich Dinge merken oder mit anderen Agenten arbeiten kann, gilt zusätzlich eine zweite Liste: die OWASP Top 10 für agentische Anwendungen (Dezember 2025) 7. Drei weitere sollte man beim Namen kennen: Tool-Missbrauch, bei dem ein Agent mit einem breiten Datenbank-Werkzeug am Ende einen Befehl ausführt, den niemand beabsichtigt hat; Identitätsmissbrauch, bei dem ein Agent einen Master-API-Schlüssel erbt statt eigener, eng gefasster Zugangsdaten und dann Daten erreicht, die kein einzelner Nutzer sehen sollte; und Memory Poisoning, bei dem ein manipuliertes Dokument in einer Wissensdatenbank unbemerkt verändert, was der Agent für alle künftigen Fälle für wahr hält. Ein einfacher Chatbot braucht die erste Liste. Ein Agent braucht beide, und diese Begriffe zu kennen zeigt, ob Ihr Team auf die echten Risiken testet oder nur auf das bekannteste.
In der Praxis heißt „fertig“: eine dokumentierte Testsuite für Prompt Injection mit verfolgter Erfolgsquote und eine schriftliche Liste jedes Werkzeugs, das der Agent nutzen darf, mit Begründung und mit dem geringstmöglichen Zugriff.
In IBMs „Cost of a Data Breach 2025“ 8, einer Ponemon-Studie unter 600 betroffenen Organisationen, meldeten 13 % Verletzungen von KI-Modellen oder -Anwendungen, und bei 97 % davon fehlten angemessene Zugriffskontrollen für KI. 63 % der untersuchten betroffenen Organisationen hatten keine KI-Governance-Richtlinie oder entwickelten noch eine.
Compliance: Ist es nach einem echten Standard dokumentiert?
Für ein Unternehmen in der EU gelten drei Ebenen, die unterschiedliche Aufgaben haben. AIUC-1 9 prüft, wie sich der Agent tatsächlich verhält, in sechs Bereichen: Daten und Datenschutz, Sicherheit (Security), Schutz (Safety), Zuverlässigkeit, Rechenschaftspflicht und Gesellschaft. ISO 42001 10 prüft die KI-Managementrichtlinien der Organisation; die eine prüft das System, die andere das Unternehmen, das es betreibt. Darunter liegen die Gesetze selbst: Die DSGVO regelt alle personenbezogenen Daten, die das System berührt, unabhängig davon, welchem KI-spezifischen Standard Sie folgen; die EU-KI-Verordnung (AI Act) ergänzt eigene Pflichten für Hochrisiko-Systeme mit zeitlicher Verzögerung (siehe unten); Branchenregeln kommen dort obendrauf, wo sie gelten, insbesondere im Gesundheitswesen und im Finanzsektor. AIUC-1 und ISO 42001 sind so gebaut, dass sie sich direkt darauf abbilden lassen – genau dafür verwendet man sie, statt eine eigene Checkliste zu erfinden.
Kontrolle: Könnten Sie jeden Vorfall untersuchen?
Jede Aktion eines Agenten wird so detailliert protokolliert, dass sich ein Vorfall allein anhand der Protokolle lückenlos untersuchen lässt. Deloitte 1 sieht das genauso: Organisationen brauchen manipulationssichere Protokolle, die zeigen, was ein Agent getan hat, warum und in wessen Auftrag. Hinzu kommen Kontrolle darüber, welche Werkzeuge er nutzen darf, und Grenzen für das, was er ausgeben darf.
Sicherheit und Compliance verdienen jeweils einen eigenen ausführlichen Beitrag; das Obige ist die Checklisten-Version.
Warum das EU-Datum wichtig ist
Die überarbeitete Produkthaftungsrichtlinie 11 gilt für Produkte, die ab dem 9. Dezember 2026 in Verkehr gebracht oder in Betrieb genommen werden, und Software, auch KI, gilt als Produkt. Die Haftung hängt nicht von einem Verschulden ab. Nur natürliche Personen können Ansprüche geltend machen, und nur für drei Arten von Schäden: Tod oder Körperverletzung, einschließlich medizinisch anerkannter Schäden an der psychischen Gesundheit; Schäden an Sachen, mit Ausnahme des fehlerhaften Produkts selbst und von Sachen, die ausschließlich für berufliche Zwecke verwendet werden; sowie die Vernichtung oder Beschädigung von Daten, die nicht für berufliche Zwecke verwendet werden. Gerichte können vermuten, dass ein Produkt fehlerhaft ist, etwa wenn der Beklagte relevante Beweismittel nicht offenlegt. Diese Vermutungen lassen sich nur mit Nachweisen widerlegen, die zum jeweiligen Zeitpunkt festgehalten wurden und belegen, dass das System spezifiziert, getestet, überwacht und kontrolliert wurde. Die Hochrisiko-Regeln der KI-Verordnung kommen später: Das KI-Omnibus-Paket 12 hat sie für eigenständige Systeme auf Dezember 2027 und für KI in regulierten Produkten auf August 2028 verschoben. Das ist eine allgemeine Orientierung, keine Rechtsberatung.
Prüfen Sie es selbst
Fragen Sie: Wenn die Rechtsvertretung eines Kunden morgen fragen würde, wie dieses System getestet wurde, was würden wir ihr vorlegen? Wenn die Antwort ein Richtliniendokument statt Testergebnisse und Protokolle ist, ist diese Lücke offen.
In meinem Testsystem
Der Benchmark verzeichnete in beiden Runden null Guardrail-Verstöße (Versuche, eine Sicherheitsregel zu brechen), und jeder Fall hat seinen eigenen Trace, sodass sich jede einzelne Entscheidung Schritt für Schritt nachprüfen lässt.
Fünf Fragen, die Sie Ihrem Team am Montag stellen sollten
Eine Frage pro Lücke. Eine vage Antwort zeigt Ihnen, wo Sie ansetzen müssen.
- Beobachtbarkeit: Können Sie mir einen Fall aus der letzten Woche allein anhand der Protokolle durchgehen?
- Bewertung: Wie viele Testfälle haben wir, woher stammen sie, wann liefen sie zuletzt, und wohin entwickelt sich die Erfolgsquote?
- Optimierung: Was war die letzte Änderung, die wir wegen eines Testergebnisses gemacht haben, und welche Zahl hat sich bewegt?
- Zuverlässigkeit: Können Sie mir drei Fälle zeigen, in denen eskaliert wurde, und einen, in dem es hätte eskaliert werden sollen, aber nicht geschah?
- Governance: Wenn die Rechtsvertretung eines Kunden morgen fragen würde, wie das getestet wurde, was würden wir ihr vorlegen?
Wo Sie anfangen
Ein Pilotprojekt, das funktioniert, hat die Idee bewiesen; für den Produktivbetrieb müssen Sie außerdem sehen, was es getan hat, wissen, dass es richtig ist, es weiter verbessern, bei Unsicherheit sicher übergeben und all das nachweisen. Prüfen Sie es selbst mit diesen fünf Fragen, oder machen Sie den 2-Minuten-KI-Check, um zu sehen, wo Sie stehen.
Wenn Sie ein Pilotprojekt haben, das funktioniert, aber noch nicht bereit ist, schließt der KI-Implementierungssprint diese fünf Lücken; die Methode sehen Sie in meinem Praxisbeispiel. Haben Sie noch kein Pilotprojekt, oder setzt Ihres einen Agenten ein, wo ein einfacheres Werkzeug genügen würde (was Deloitte [1] „Agent Washing“ nennt), startet derselbe Sprint bei „noch nichts gebaut“, und Woche eins prüft, ob sich der Bau überhaupt lohnt. So oder so: Prüfen Sie es zuerst selbst, oder fragen Sie mich, dann gehen wir es gemeinsam durch.
Quellen
- Deloitte Insights, Tech Trends 2026: The agentic reality check (Dez. 2025)
- S&P Global Market Intelligence, VotE: AI & Machine Learning, Use Cases 2025
- MIT NANDA, The GenAI Divide: State of AI in Business 2025
- LangChain, State of Agent Engineering
- IBM Technology, Are Your AI Agents Flying Blind? The Truth About AgentOps
- OWASP Top 10 for LLM Applications 2025
- OWASP Top 10 for Agentic Applications (Dec 2025)
- IBM, Cost of a Data Breach Report 2025
- AIUC-1
- ISO/IEC 42001:2023
- Richtlinie (EU) 2024/2853
- Verordnung (EU) 2026/1744
Zitate aus Stellenbeschreibungen (aus dem Englischen übersetzt): SmartProduct-Analyse von 936 Stellenbeschreibungen für KI-Führungskräfte (August bis September 2026)